AI 모델 업데이트 속도가 정말 무섭습니다.
“새 모델 나왔네?” 하고 기존 모델 좀 써볼까 하면 다음 모델이 나오고, 비교 글 하나 쓰려고 자료를 찾다 보면 또 새 모델이 등장합니다.
이번 주인공은 Anthropic입니다.
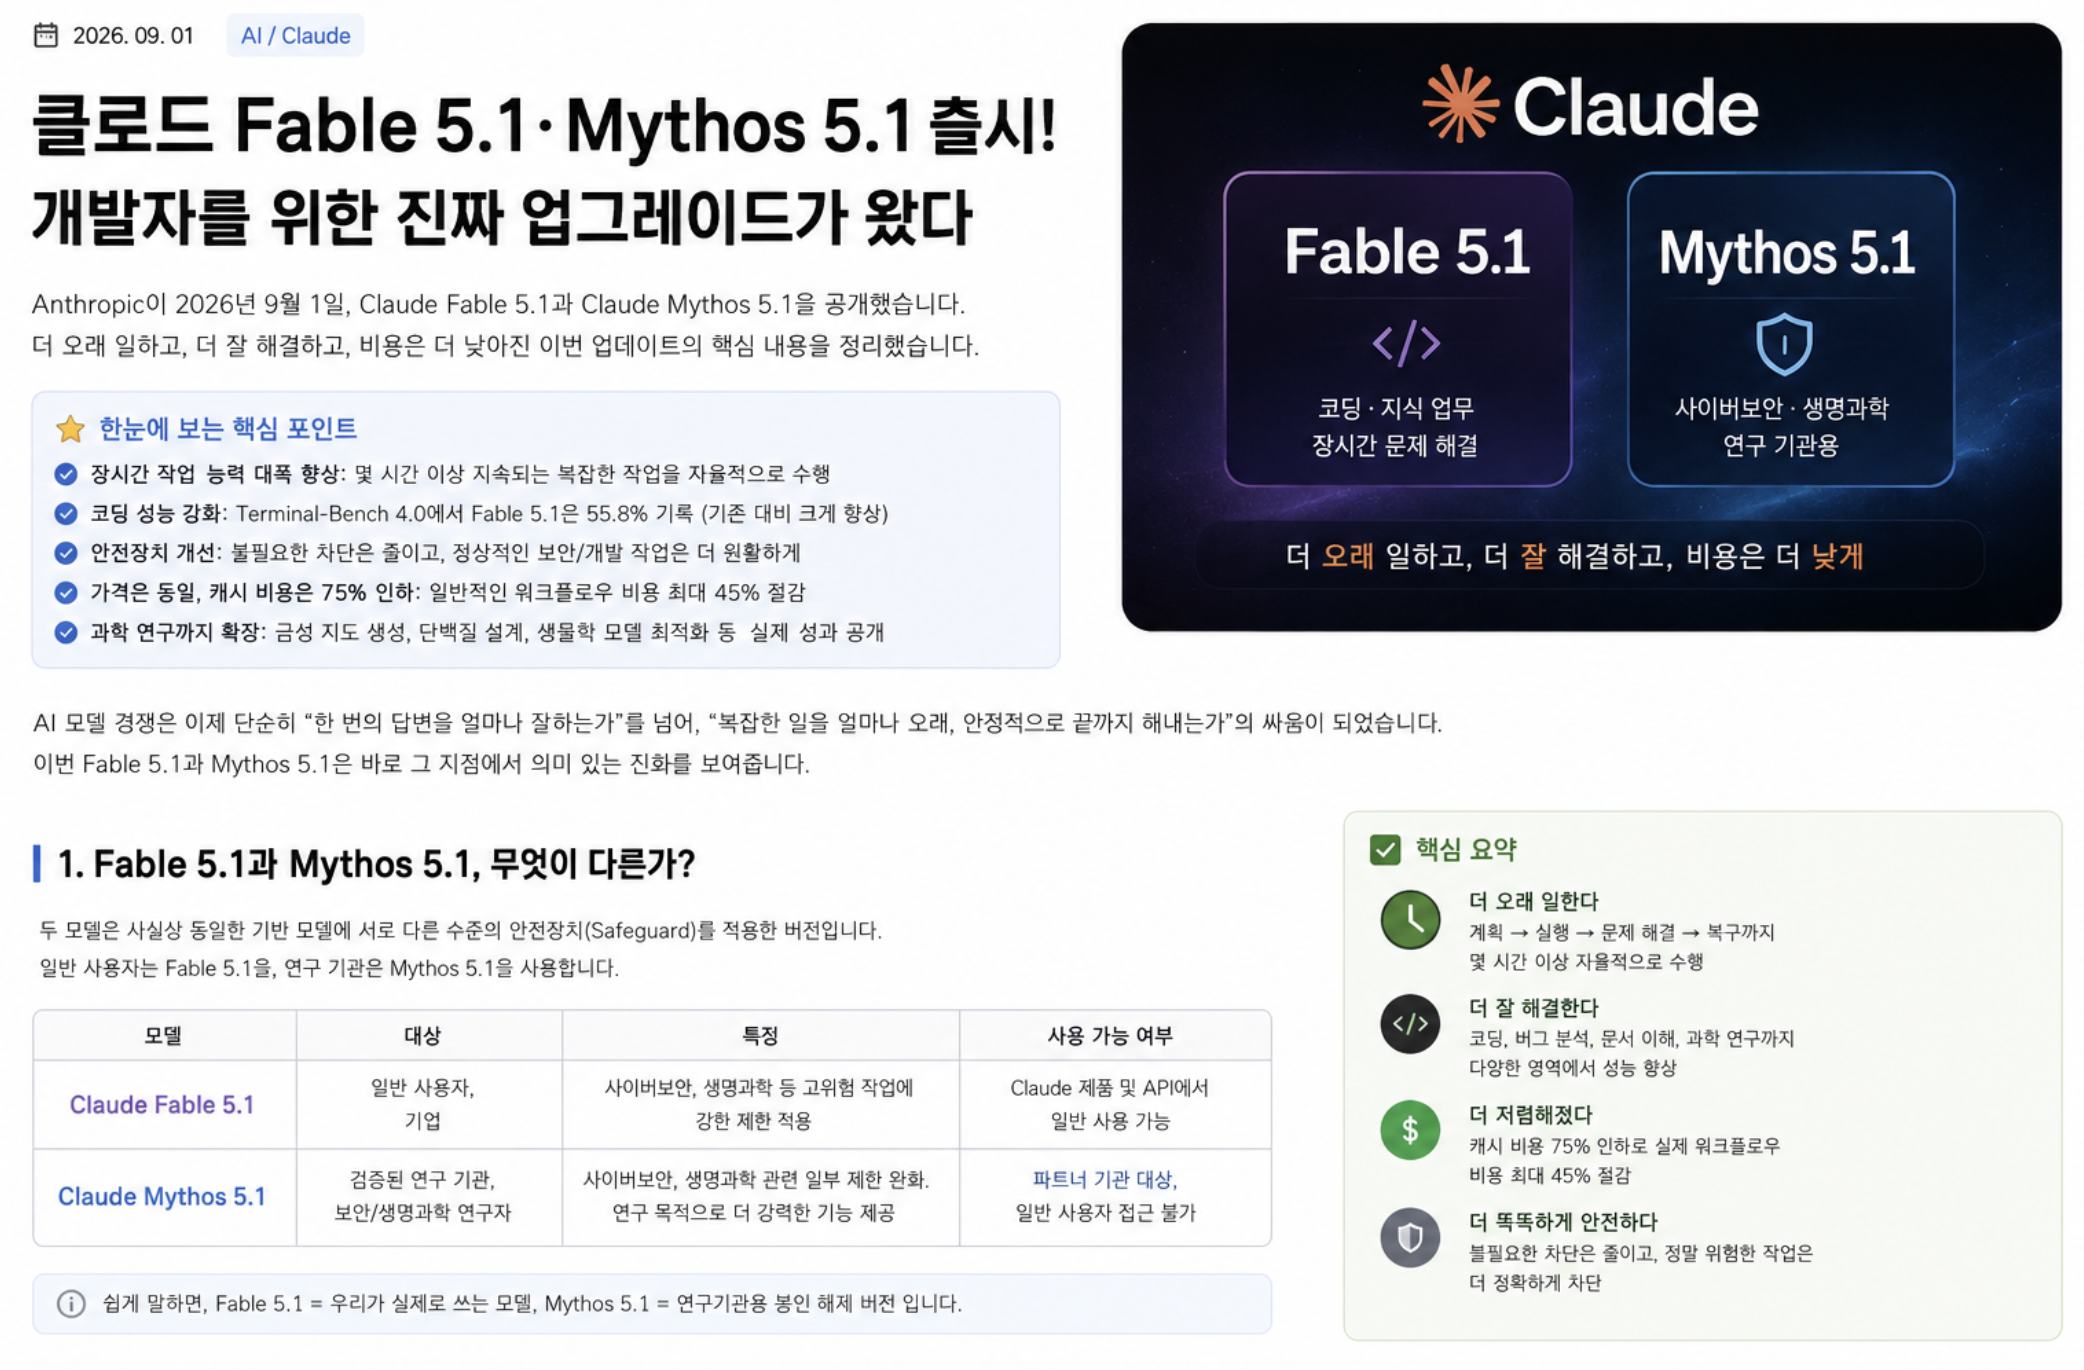
Anthropic은 2026년 9월 1일 Claude Fable 5.1과 Claude Mythos 5.1을 새롭게 공개했습니다. 단순히 숫자 뒤에 .1 하나 붙인 소규모 업데이트처럼 보이지만, 내용을 살펴보면 생각보다 변화가 상당합니다.
특히 Claude Code를 이용해서 장시간 코딩 작업을 돌리거나 AI 에이전트에게 큰 작업을 통째로 맡기는 사용자라면 이번 업데이트를 꽤 주목할 필요가 있습니다.
Anthropic 역시 Fable 5.1을 코딩, 지식 업무, 장시간 문제 해결에 초점을 맞춘 모델로 소개하고 있습니다.
Claude Fable 5.1과 Mythos 5.1, 뭐가 다른데?
우선 이름부터 조금 헷갈립니다.
이번에 공개된 모델은 두 가지입니다.
- Claude Fable 5.1
- Claude Mythos 5.1
그런데 재미있는 점은 두 모델이 사실상 같은 기반 모델이라는 것입니다.
차이는 모델 자체의 지능이라기보다는 적용되는 안전장치(Safeguard)의 수준에 있습니다.
Fable 5.1은 일반 사용자와 기업이 사용할 수 있도록 사이버보안이나 생명과학 관련 위험한 작업에 강한 제한을 적용한 버전입니다.
반대로 Mythos 5.1은 사이버보안 연구나 생명과학 연구처럼 보다 강력한 기능이 필요한 검증된 기관을 대상으로 일부 제한을 완화한 버전입니다. 따라서 일반 사용자가 Claude에 접속해서 Mythos 5.1을 선택하는 형태는 아닙니다.
쉽게 표현하면 이렇습니다.
Fable 5.1 = 우리가 실제로 사용할 모델
Mythos 5.1 = 연구기관용 봉인 해제 버전
정도로 이해하면 편합니다.
Fable 5.1에서 가장 크게 달라진 것은 '오래 일하는 능력'
요즘 AI 개발 도구의 경쟁은 단순히
“코드 한 함수 잘 만들어 줍니다.”
수준에서 이미 한참 벗어났습니다.
이제 중요한 것은
“이 프로젝트 통째로 분석하고 문제 찾아서 수정하고 테스트까지 해줘.”
같은 요청을 얼마나 안정적으로 처리할 수 있느냐입니다.
Fable 5.1은 바로 이 부분을 상당히 강화했습니다.
Anthropic은 Fable 5.1이 계획을 세우고, 여러 도구를 사용하고, 작업 도중 문제가 발생하면 스스로 복구하면서 몇 시간 이상 이어지는 작업을 수행하도록 설계됐다고 설명합니다. Claude Code에서는 기본적으로 High Effort가 적용됩니다.
실제 사전 테스트 사례도 꽤 재미있습니다.
MongoDB에서는 Fable 5.1이 여러 서비스의 코드와 문서를 조사한 뒤 복잡한 프로토타입을 설계하고, 몇 시간 동안 사람의 개입 없이 구현 작업을 이어갔다고 밝혔습니다.
Ramp의 테스트에서는 머신러닝 문제를 대상으로 38시간 동안 무인 작업을 진행하면서 기존 결과를 다시 검토하고 여러 실험까지 병렬로 수행한 사례도 공개됐습니다.
이 정도가 되면 슬슬 AI에게
“이거 고쳐줘.”
라고 부탁하는 게 아니라,
“나 퇴근할 테니까 이것 좀 끝내놔.”
라고 말하는 시대가 오는 것 같습니다.
Claude Code 성능도 크게 올라갔다
개발자 입장에서 가장 관심이 갈 부분은 역시 코딩 성능입니다.
Anthropic이 공개한 벤치마크를 보면 Fable 5.1은 상당수 영역에서 기존 Fable 5와 Opus 5를 넘어섰습니다.
대표적으로 Agentic Coding 평가인 Terminal-Bench 4.0에서 Fable 5.1은 55.8%, Mythos 5.1은 60.9%를 기록했습니다.
기존 Fable 5는 42.0%, Opus 5는 52.3%였습니다.
CursorBench 3.2.0에서도 Fable 5.1은 **73.4%**를 기록해 Fable 5의 70.5%, Opus 5의 70.0%보다 높은 결과를 냈습니다.
더 인상적인 것은 단순 코드 생성보다 문제의 원인을 찾아내는 능력입니다.
Millennium의 테스트에서는 약 4~5년 동안 원인을 찾지 못했던 극히 드문 프로그램 충돌 문제를 Fable 5.1이 분석했습니다.
외부 라이브러리를 분석하고 코어 덤프와 비교한 뒤 결국 외부 라이브러리 내부의 버그까지 추적해냈다고 합니다.
백엔드 개발을 하다 보면 이런 문제가 정말 무섭습니다.
로그에는 별것도 없고, 우리 코드에는 문제가 없어 보이고, 재현은 안 되고….
사람이 가장 싫어하는 바로 그 종류의 버그입니다.
이런 문제를 AI가 장시간 물고 늘어지면서 분석할 수 있다는 것이 Fable 5.1에서 상당히 중요한 변화라고 볼 수 있습니다.
그런데 가격은 오히려 내려갔다
성능이 올라갔으니 당연히 가격도 올라갔겠지 싶지만 의외로 그렇지 않습니다.
Fable 5.1 API 기본 가격은 기존 Fable 5와 동일합니다.
- 입력: 100만 토큰당 10달러
- 출력: 100만 토큰당 50달러
여기까지만 보면 별 변화가 없습니다.
하지만 중요한 것이 Prompt Cache 비용입니다.
Fable 5.1의 Cache Read 가격은 100만 토큰당 0.25달러로 낮아졌습니다. 이전보다 75% 저렴해진 가격입니다.
이게 Claude Code 같은 에이전트 환경에서는 꽤 중요합니다.
AI가 프로젝트 전체를 계속 읽고 작업하다 보면 이전 대화와 코드 컨텍스트를 반복해서 참조하게 됩니다.
Anthropic의 실제 사용량 분석 기준으로는 Fable 5와 비교했을 때 일반적인 작업의 비용이 약 25% 감소하고, 컨텍스트와 도구 사용량이 많은 Agentic Workflow에서는 최대 약 45%까지 비용이 줄어들 수 있다고 합니다.
즉 이번 업데이트는 단순히
“더 똑똑해졌습니다.”
가 아니라
“더 오래 일하면서 비용도 줄였습니다.”
에 가깝습니다.
Claude Code를 장시간 돌리는 사람에게는 사실 벤치마크 몇 점 상승보다 이쪽이 훨씬 반가운 변화일 수도 있습니다.
지나치게 막히던 Claude도 조금 덜 답답해졌다
기존 Fable 5에는 강력한 안전장치가 적용되어 있었습니다.
문제는 안전장치가 너무 민감하게 반응하면서 정상적인 개발이나 보안 관련 질문까지 차단되는 경우가 있었다는 것입니다.
Anthropic도 이 문제를 인지했고 Fable 5.1에서 안전장치를 좀 더 정교하게 수정했습니다.
특히 Claude Code를 사용할 때 사이버보안 관련 안전장치가 개입하는 빈도가 기존 Fable 5 대비 평균 약 60% 감소할 것으로 예상한다고 밝혔습니다.
소스코드에서 보안 취약점을 찾는 것도 이제 Fable 5.1에서 허용됩니다.
다만 침투 테스트, 실제 Exploit 생성, 바이너리를 이용한 취약점 스캔 등 위험성이 높은 작업은 여전히 제한되고 다른 모델로 전환될 수 있습니다.
즉,
“버그와 취약점 좀 찾아줘.”
정도는 훨씬 편해졌지만,
“그 취약점 실제로 공격하는 코드까지 만들어줘.”
단계로 넘어가면 제한이 걸릴 수 있다는 이야기입니다.
AI가 과학 연구까지 직접 하기 시작했다
이번 발표에서 의외로 상당한 비중을 차지하는 것이 과학 연구입니다.
Claude Fable 5.1은 NASA의 기존 금성 레이더 데이터를 이용해 금성 표면 약 3분의 1에 해당하는 새로운 고해상도 고도 지도를 만드는 작업도 수행했습니다.
기존 데이터의 해상도가 약 10~20km 수준이었다면 새 결과에서는 2~3km 정도의 세부 지형까지 확인할 수 있게 됐다고 Anthropic은 설명합니다.
Mythos 5.1의 경우 단백질 결합체 설계 작업에도 투입됐습니다.
또 여러 오픈소스 생물학 딥러닝 모델의 GPU 코드를 최적화해서 일부 모델의 추론 속도를 최대 2.5배까지 높인 사례도 공개됐습니다.
개인적으로 이번 발표에서 흥미로운 부분은 바로 이것입니다.
AI 모델 경쟁이 지금까지는
코딩 잘한다 → 글 잘 쓴다 → 검색 잘한다
정도였다면 이제는 점점
직접 조사하고, 실험하고, 결과를 검증하는 단계
로 이동하고 있습니다.
그렇다면 Opus 5 대신 Fable 5.1을 써야 할까?
여기서 자연스럽게 생기는 질문이 하나 있습니다.
“그럼 Claude Opus 5는 이제 필요 없는 거 아닌가?”
현재 기준으로는 그렇게 단순하지 않습니다.
Opus 5는 여전히 일반적인 작업을 효율적으로 수행하는 상위 모델이고 API 기준 입력 5달러, 출력 25달러로 Fable 5.1보다 기본 토큰 가격이 절반입니다.
반면 Fable 5.1의 장점은 난도가 높고 오래 걸리는 작업을 끝까지 해결하는 능력에 있습니다.
따라서 대략 다음처럼 나누면 좋습니다.
Sonnet 5
일상적인 코딩, 빠른 작업, 비용 효율이 중요할 때.
Opus 5
높은 품질의 코딩과 분석을 자주 수행하는 일상적인 상위 모델이 필요할 때.
Fable 5.1
대규모 리팩터링, 전체 코드베이스 분석, 복잡한 장애 원인 분석, 장시간 Claude Code 작업처럼 AI에게 큰 업무를 통째로 맡기고 싶을 때.
특히 Claude Code에서 긴 작업을 많이 실행한다면 이번 Fable 5.1은 꽤 매력적인 선택지가 될 것으로 보입니다.
결국 Claude Fable 5.1의 핵심은 'AI 직원'에 한 발 더 가까워졌다는 것
이번 Claude Fable 5.1을 단순히 벤치마크 숫자로만 보면 조금 심심할 수도 있습니다.
하지만 실제 변화 방향을 보면 꽤 재미있습니다.
예전의 생성형 AI가 질문을 던지고 답변을 받는 챗봇이었다면, 최근 Claude Code나 Codex 같은 도구들은 점점 하나의 업무를 넘겨받아 스스로 계획하고 실행하는 에이전트로 변하고 있습니다.
Fable 5.1은 그 흐름을 상당히 노골적으로 보여주는 모델입니다.
몇 시간 또는 하루 이상 작업을 이어가고, 중간에 실패하면 다시 방법을 찾고, 코드를 수정하고 테스트하고 결과를 검증합니다.
거기에 이번에는 캐시 비용까지 크게 줄였습니다.
결국 Anthropic이 노리는 방향은 꽤 명확해 보입니다.
더 똑똑한 챗봇을 만드는 것보다, 더 큰 일을 통째로 맡길 수 있는 AI를 만드는 것.
Claude Code를 자주 사용하는 개발자라면 앞으로 Fable 5.1을 이용해서 단순 코드 작성보다는 프로젝트 전체 분석, 리팩터링, 장애 분석, 테스트 자동화처럼 작업 범위를 크게 잡아보는 것이 이번 모델의 능력을 제대로 활용하는 방법일 것 같습니다.
이제 정말 프롬프트도
“이 함수 만들어줘.”
보다는
“이 프로젝트 문제점 찾아서 알아서 고치고 테스트까지 해놔.”
라고 작성해야 할 시대가 오고 있는지도 모르겠습니다.
'IT > AI' 카테고리의 다른 글
| Claude Max 집단소송, ‘5배·20배 사용량’은 왜 문제가 됐을까? (3) | 2026.09.10 |
|---|---|
| OpenAI GPT Image 2.5 출시 총정리: Flare vs Sunburst 차이와 Nano Banana·Midjourney 비교 (4) | 2026.09.09 |
| GPT-6 Astra vs GPT-5.6 Sol 비교: 2.5배 비싼데 오히려 토큰을 아낀다? 성능,비용,실사용 후기 총정리 (2) | 2026.09.07 |
| GPT-6 Astra vs Claude Fable 5.1 비교(코딩,성능,가격 등) (4) | 2026.09.05 |
| Codex 추론 레벨 정리: Light·Medium·High·Extra High·Ultra 차이와 울트라 모드 사용법 (7) | 2026.08.27 |


